
本地识别
使用本地模型时,录音在这台电脑上完成识别,音频不会离开本机。在侧栏打开「语音模型」,选择「本机」,下载一个模型即可。下载完成后,也可以点首页或页面标题下方的语音模型名称切换到这个模型。
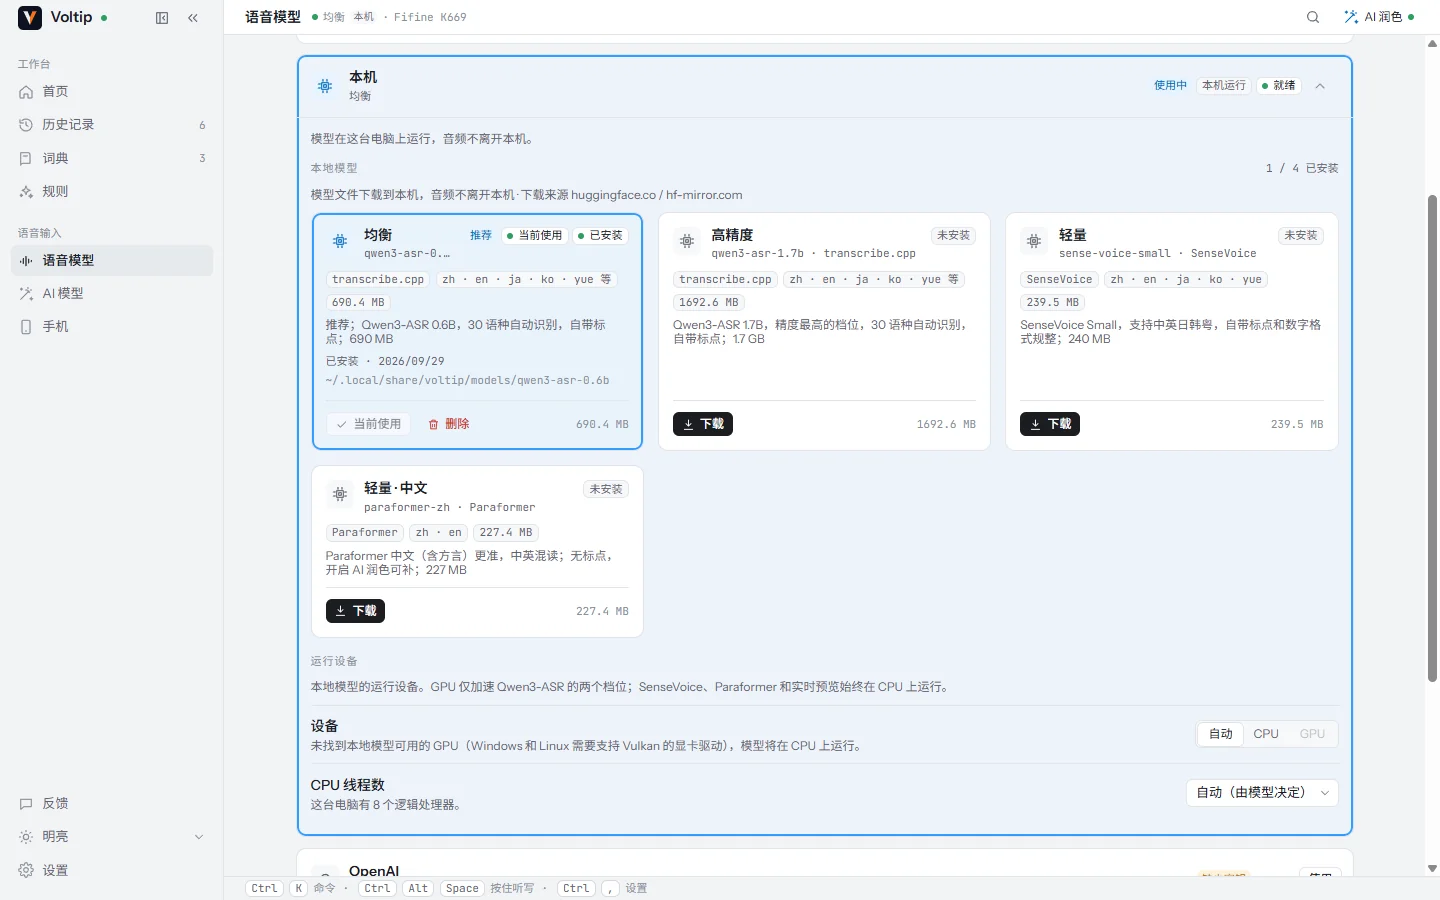
模型
| 模型 | 大小 | 语言 | 运行设备 | 说明 |
|---|---|---|---|---|
| Qwen3-ASR 0.6B | 690 MB | 30 种语言,自动识别 | GPU 或 CPU | 推荐。自带标点 |
| Qwen3-ASR 1.7B | 1.7 GB | 30 种语言,自动识别 | GPU 或 CPU | 最准确,速度较慢。与内置服务使用的是同一个模型 |
| SenseVoice Small | 240 MB | 中文、英文、日文、韩文、粤语 | CPU | 体积最小。自带标点,并规整数字写法 |
| Paraformer | 227 MB | 中文(含方言)与英文混说 | CPU | 中文识别更准。不带标点,开启 AI 润色可以补上 |
| 实时识别 | 169 MB | 中文与英文 | CPU | 边说边显示文字(「本地模型预览」,见说话时显示的文字)。最终文本仍由上面选用的模型识别;使用内置服务时不需要 |
「语音模型」页「识别设置」中的「语言」,会传给支持指定语言的模型和服务;Qwen3-ASR 始终自动识别语言。
开启「静音裁剪」后,一个 1.8 MB 的静音检测模型会随第一个本地模型一起下载。
较长的录音
本地模型一次识别的录音越长,漏掉的字越多。在我们用 FLEURS 测试集的中文、英文语音所做的测试中,SenseVoice Small 的中文字错率在 30 秒时为 8.9%,60 秒时升到 16.7%;Qwen3-ASR 0.6B 的英文词错率从 30 秒时的 4.8% 升到 60 秒时的 10.7%,90 秒时为 20.4%;Paraformer 和 Qwen3-ASR 1.7B 的英文同样在 60 秒时明显变差。因此,不论用哪个本地模型,超过 30 秒的录音都会在停顿处分成几段,逐段识别后拼成一段文字。这一过程自动完成,无需设置;超过 2 分钟的录音照常在录制过程中分段识别。
取消一次听写后,下一次听写不需要等上一次的识别全部结束:使用 SenseVoice 或 Paraformer 时,被取消的识别在后台跑完,下一次听写用另一份模型识别,换了语言或模型也不用等;使用 Qwen3-ASR 时,最多等正在识别的那一段完成。本机模型识别出错后,下一次听写会重新加载它。
下载
- 正式版安装包先从项目自己的镜像下载,然后依次尝试 Hugging Face 和 hf-mirror.com。某个来源速度过慢或无法访问时,Voltip 会自动换到下一个。
- 实时识别模型已不在 Hugging Face 上。项目自己的镜像之后,它从 GitHub 上 sherpa-onnx 项目的发布页下载,是一个压缩包,Voltip 从中取出模型文件。已经下载的模型不用重新下载。
- 下载中断后,会从中断处继续。
- 每个文件在使用前都会校验 SHA-256。
- 开始下载前,Voltip 会检查磁盘剩余空间是否足够。
模型默认保存在 Voltip 数据目录下的 models 目录中(数据目录的位置),也可以换到其他文件夹,见保存位置。在「语音模型」页删除模型会同时删除它的文件。
保存位置
系统盘空间不够时,可以把模型放到其他磁盘:在「本机」下的「保存位置」中点「更改位置…」,选择一个文件夹,已下载的模型会一起移过去。
- 在同一块磁盘上,移动立即完成。换到另一块磁盘时,Voltip 先复制并检查全部文件,再切换到新位置,最后删除旧位置的文件。页面上会显示进度,复制过程中可以点「取消移动」。
- 移动没有完成时(取消、空间不足或其他错误),模型仍在原来的位置,可以照常使用。
- 移动期间不能下载或删除模型;有模型正在下载时,要等下载完成或取消下载后才能更改位置。
- 旧位置的文件仍在使用、暂时无法删除时,Voltip 会在下次启动时删除。
- 所选文件夹里已经有完整的同一个模型时(例如重装系统后再次选择原来的文件夹),Voltip 会直接使用它,不再复制。
点「恢复默认」可以把模型移回数据目录。之后下载的模型都保存到当前的位置。
手动下载
无法在应用中下载模型时(例如所在网络只能在另一台设备上访问下载源),可以手动下载:
- 在模型卡片上点「手动下载」,查看这个模型的文件夹和需要下载的文件。
- 在浏览器中打开每个文件的下载地址(Hugging Face 或 hf-mirror.com),也可以复制地址,在其他设备上下载;把文件保存到卡片上显示的文件夹,文件名保持不变。点「打开文件夹」可以直接打开这个文件夹,点「复制路径」可以复制它的位置。
- 全部文件放好后,点「检查并导入」。Voltip 会校验每个文件的大小和 SHA-256,全部正确后即可使用这个模型;有文件缺少或不正确时,卡片会列出这些文件。
实时识别模型的卡片上列出的是一个压缩包:下载后不用解压,直接放进这个文件夹。点「检查并导入」时,Voltip 从包里取出模型文件,然后删除这个包。
在应用中下载时,文件夹里已有的文件也会先校验,不正确的文件会重新下载。
CPU 与 GPU
在「本机」下,「运行设备」提供三个选项:
- 自动(默认):这台电脑有 Voltip 可用的显卡时使用显卡,否则使用处理器。
- CPU:始终使用处理器,可以通过「CPU 线程数」设置使用的线程数。
- GPU:使用显卡;有多块显卡时可以选择其中一块。
只有两个 Qwen3-ASR 模型会使用显卡:Windows 和 Linux 上通过 Vulkan,需要显卡驱动支持 Vulkan;Mac 上通过 Metal。SenseVoice、Paraformer 和实时识别模型始终在处理器上运行。显卡无法使用时,Voltip 会改用处理器,听写不受影响。
识别过程中显卡出错时,Voltip 会用处理器重新识别这条录音,历史记录详情中的「识别方式」会写明。10 分钟内再次出错后,在重启 Voltip 之前都使用处理器。
第一次在显卡上运行需要更长时间,因为驱动要为这个模型做一次准备:在我们的实测中,NVIDIA L40S 上约 13 秒,Tesla T4 上约 2 分钟。之后的运行启动很快。
实测数据
Qwen3-ASR 0.6B 识别一段 16 秒的中文语音(首次运行之后):
| 电脑 | 设备 | 加载 | 识别 |
|---|---|---|---|
| Linux,NVIDIA L40S | GPU(Vulkan) | 0.58 秒 | 0.16 秒 |
| Linux,同一台电脑 | CPU,8 个线程 | — | 2.87 秒 |
| Windows,NVIDIA Tesla T4 | GPU(Vulkan) | 1.6 秒 | 0.28 秒 |
SenseVoice Small(int8)识别同一段录音用时 0.20 至 0.34 秒,测试机为 32 核服务器处理器,使用 4 个线程。
Voltip 启动时以及每次更改设置后,都会在后台加载选用的模型,因此第一次听写不需要等待加载。
处理器要求
在 x86 电脑上,Qwen3-ASR 需要支持 AVX2 的处理器:2013 年(Haswell)以后的 Intel 处理器,以及 2015 年以后的 AMD 处理器。在更早的处理器上,Voltip 会说明无法加载的原因,请改用 SenseVoice、Paraformer 或云端服务。使用 Apple 芯片的 Mac 原生运行这些模型。
出错时改用其他本地模型
「语音模型」页的候补列表可以添加已下载的本地模型(见服务出错时也改用候补)。当前选择的是本地模型时:
- 开启「额度用完后改用其他模型」和「服务出错时也改用候补」后,显卡、内存或模型出错,且用处理器重新识别也失败时,这条录音改由列表中的下一个本地模型识别。
- 列表中的云端服务商不会用到:本地识别出错时,录音不会上传到云端。列表中只有云端服务商时,这条听写照常提示识别失败。
- 本地模型没有额度限制,只开启「额度用完后改用其他模型」时不会改用其他模型。
当前选择的是云端服务商时,列表中的本地模型也可以在额度用完或服务出错时接替识别。
中文字形
部分模型会把中文识别为繁体字。在「识别设置」的「中文字形」中,可以选择简体(默认)、繁体或保持原样。字形转换在识别之后立即进行,早于词典纠正。
命令行
这些模型也可以在不打开应用窗口的情况下使用,适合脚本和服务器:
voltip-desktop --list-models
voltip-desktop --download-model qwen3-asr-0.6b
voltip-desktop --transcribe-file sample.wav --json
voltip-desktop --list-compute全部选项见命令行。